Internet sta perdendo la memoria
Nel tentativo di tenere lontane le AI, siti e giornali online stanno anche rendendo più difficile il mantenimento di un archivio pubblico
- Condividi
- X
- Regala il Post
Ogni giorno una quantità incalcolabile di contenuti online – articoli, immagini, documenti, siti interi – viene modificata, sostituita o rimossa, per le ragioni più varie. E non ne resterebbe alcuna traccia pubblica, se non fosse per un’organizzazione non profit chiamata Internet Archive, che da trent’anni raccoglie e archivia miliardi di pagine web attraverso il sito Wayback Machine, una specie di collezione di copie istantanee delle pagine dei siti, inclusi quelli che non esistono più.
Su Wayback Machine è possibile consultare ogni sito com’è oggi e com’è cambiato attraverso gli anni, i mesi e i giorni, visualizzando le pagine archiviate, che sono oltre mille miliardi. Negli ultimi tempi però il lavoro dell’organizzazione è diventato sempre più difficile perché un numero crescente di siti sta implementando misure per impedire che i propri contenuti siano utilizzati dai modelli di intelligenza artificiale (AI) che fanno funzionare chatbot e altre applicazioni. Queste misure, come effetto collaterale, hanno reso inaccessibili i siti anche per Internet Archive.
In pratica, per impedire ai modelli di AI di usare senza autorizzazione contenuti pubblicati online, quei contenuti vengono resi “invisibili” anche per chi si occupa di raccoglierli in un archivio pubblico condiviso. Sembra una questione marginale, ma ci sono vari motivi per cui tenere traccia di ciò che viene pubblicato online è importante. Tra questi c’è una maggiore responsabilizzazione di chi pubblica e, soprattutto, una valorizzazione di Internet come patrimonio pubblico permanente di conoscenza umana.
Al momento, è un obiettivo lontano. «Internet dimentica continuamente», ha scritto sull’Atlantic il fondatore di Internet Archive, Brewster Kahle, in un articolo in cui ha descritto i limiti dell’approccio adottato da editori e creatori di contenuti per difendere i propri contenuti dalle AI, e i rischi che pone per la formazione e il consolidamento di una memoria condivisa.
– Leggi anche: L’Internet di oggi non è un posto per l’Internet Archive
Il modo in cui molti gestori di siti Internet hanno cominciato ormai da tempo a proteggere i loro contenuti è rendendo difficile o del tutto impossibile il cosiddetto web scraping. Senza scendere troppo nel dettaglio, è una tecnica che prevede di simulare con appositi programmi informatici (bot) la normale navigazione su un sito Internet, per estrarne dati. Wayback Machine la utilizza per salvare e conservare le copie istantanee delle pagine web, come le visualizzerebbe un utente qualsiasi. Se il contenuto della pagina è a pagamento, la copia mostrerà il messaggio del paywall, il sistema che permette l’accesso solo ai lettori paganti.
Le aziende di AI utilizzano la stessa tecnica per estrarre dai siti grandi quantità di dati che poi utilizzano per addestrare i loro modelli. Ma questo tipo di attività comporta una perdita economica per chi gestisce i siti, perché i server devono reggere grandi volumi di traffico automatizzato a cui non corrisponde un guadagno (i bot non si abbonano, né fanno clic sulle pubblicità). Inoltre i contenuti estratti possono poi essere utilizzati da chatbot e altri servizi delle aziende di AI, senza che i loro clienti passino per i siti di chi quei contenuti li ha prodotti, riducendo ulteriormente i loro possibili guadagni.
Per cercare di contenere le perdite, quindi, molti editori e gestori dei siti bloccano lo scraping dei bot delle AI. E centinaia di siti di giornali e riviste, tra cui il New York Times, il Guardian, Le Monde e l’Atlantic, ma anche molti siti di giornali locali, hanno cominciato a bloccare – in parte o completamente – anche i bot di Wayback Machine: perché è dai suoi archivi che i bot delle AI recuperano i dati dei siti a cui non possono accedere direttamente.
Da un’analisi del Washington Post del 2023 era emerso che, su 15 milioni di siti Internet utilizzati per addestrare due grandi modelli linguistici di Google e Meta, il sito di Wayback Machine (archive.org) era tra i 600 più utilizzati in assoluto.
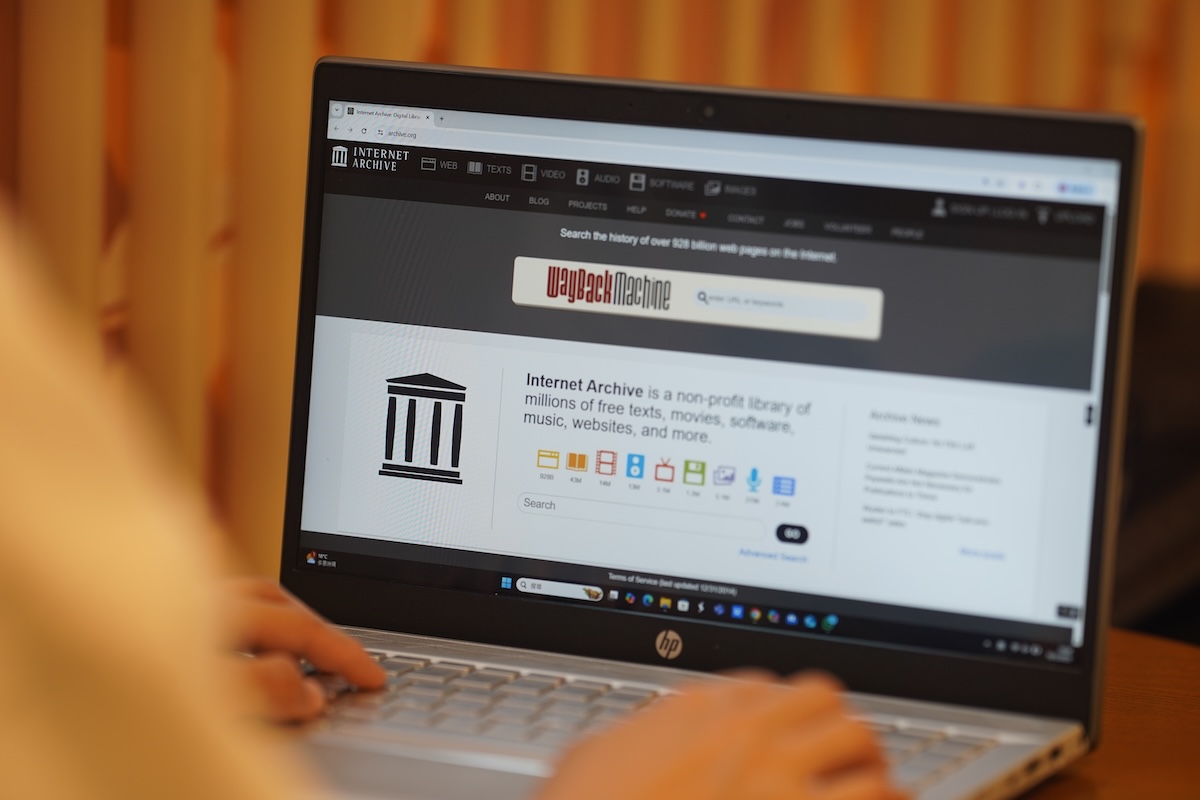
Una persona consulta Wayback Machine, in Cina, il 19 marzo 2025 (Serene Lee/SOPA Images/ZUMA Press Wire/Ansa)
Il risultato delle misure introdotte dai siti è che la raccolta delle loro pagine più recenti nell’archivio su Wayback Machine si è interrotta. «Stiamo bloccando l’accesso del bot di Internet Archive perché la Wayback Machine fornisce accesso illimitato ai contenuti del giornale, anche da parte di aziende che utilizzano l’AI, senza autorizzazione», aveva detto a gennaio un portavoce del New York Times al sito statunitense Nieman Lab, che si occupa di giornalismo.
Internet Archive ha cercato da parte sua di contrastare l’uso massiccio e indiscriminato dei propri archivi da parte delle aziende di AI, introducendo alcune misure specifiche. Una è limitare la quantità e la velocità di download, in modo da impedire a chiunque – bot o umano che sia – di scaricare in tempi brevi grandi quantità di dati dai suoi archivi. È anche un modo per cercare di ridurre il rischio di problemi tecnici per l’organizzazione stessa, come quello che nel 2023 mandò Internet Archive temporaneamente offline dopo che un’azienda di AI aveva causato un sovraccarico dei server attraverso decine di migliaia di richieste di dati al secondo.
Impedire a Internet Archive di creare copie d’archivio delle pagine web ha risvolti pratici nel presente.
Wayback Machine è uno strumento di consultazione e di archiviazione utilizzato ogni giorno da ricercatori, storici, giudici, giornalisti e molti altri professionisti, oltre che da lettori comuni. Lo usano per verificare affermazioni passate di personaggi pubblici che negano di averle mai espresse, per esempio. O per esaminare versioni precedenti di documenti governativi e comunicati istituzionali e aziendali pubblicati online e poi modificati. O, ancora, per leggere articoli di siti di news che non esistono più e di giornali che hanno chiuso.
Un pezzo enorme di Wikipedia, per dirne un’altra, funziona grazie a Internet Archive. In ciascuna voce enciclopedica, in moltissimi casi, i link a fondo pagina rimandano non agli indirizzi diretti di pagine web, ma alle versioni di quelle pagine che sono conservate su Wayback Machine. Succede perché le persone che contribuiscono a Wikipedia scrivendo o modificando le voci al suo interno riconoscono che le risorse consultate per scrivere quelle voci potrebbero nel tempo andare perdute o essere modificate. E in quel caso i link diretti rimanderebbero a pagine rotte o a contenuti incoerenti rispetto alla voce su Wikipedia.
– Leggi anche: La diffusione dei chatbot di AI è un problema per Wikipedia
Secondo uno studio condotto su un milione di pagine web dal Pew Research Center, una non profit statunitense che realizza sondaggi e studi sociali, il 38 per cento circa delle pagine che esistevano nel 2013 non era più online nel 2023. E di quelle del 2021, appena due anni prima, già una su cinque non era più online. Da una successiva analisi di Internet Archive era emerso che, degli indirizzi Internet scomparsi e presi in considerazione nello studio del Pew Research Center, il 16 per cento era ancora accessibile tramite Wayback Machine.
Il caso del blocco di Internet Archive da parte dei siti dei giornali è paradossale, perché i giornalisti professionisti sono tra gli utenti più assidui degli archivi di Wayback Machine. Nel 2017 due giornalisti del New York Times pubblicarono un reportage su alcune pratiche ed espansioni societarie sospette da parte di aziende di dermatologia. Per raccogliere le informazioni necessarie si avvalsero di dati riportati nel 2008 sul sito di un’azienda e disponibili soltanto sulla versione conservata su Wayback Machine.
È solo un esempio tra i moltissimi casi di uso quotidiano di questo strumento da parte dei giornalisti. Per questo motivo, negli ultimi mesi, centinaia di loro hanno firmato diverse petizioni online per chiedere alle testate giornalistiche di consentire a Internet Archive di conservare i loro articoli.
Kahle, il fondatore di Internet Archive, ha scritto sull’Atlantic che capisce le ragioni della rabbia e della frustrazione degli editori, perché «il giornalismo è costoso» e gli editori hanno tutto il diritto di contestare le aziende che sfruttano il loro lavoro. Ma ha aggiunto: «Bloccare una biblioteca senza scopo di lucro è la risposta sbagliata a questo problema».
È inutile, secondo Kahle, prima di tutto perché le aziende di AI hanno i mezzi per raccogliere comunque dati di addestramento per i loro modelli. E in secondo luogo perché non farà funzionare per magia il modello di business basato sulla pubblicità (e quindi sulle visualizzazioni delle pagine) che ha sostenuto il giornalismo nel Novecento e che è collassato da tempo. Quello che fa è impedire una conservazione dei dati a lungo termine, pubblica e indipendente.
È come se i giornali annunciassero alle biblioteche fisiche che non potranno più conservare copie dei loro numeri arretrati, per usare l’analogia proposta da un analista della Electronic Frontier Foundation, una delle principali organizzazioni non profit per la tutela dei diritti online.